더러운 데이터를 함부로 지우지 마세요
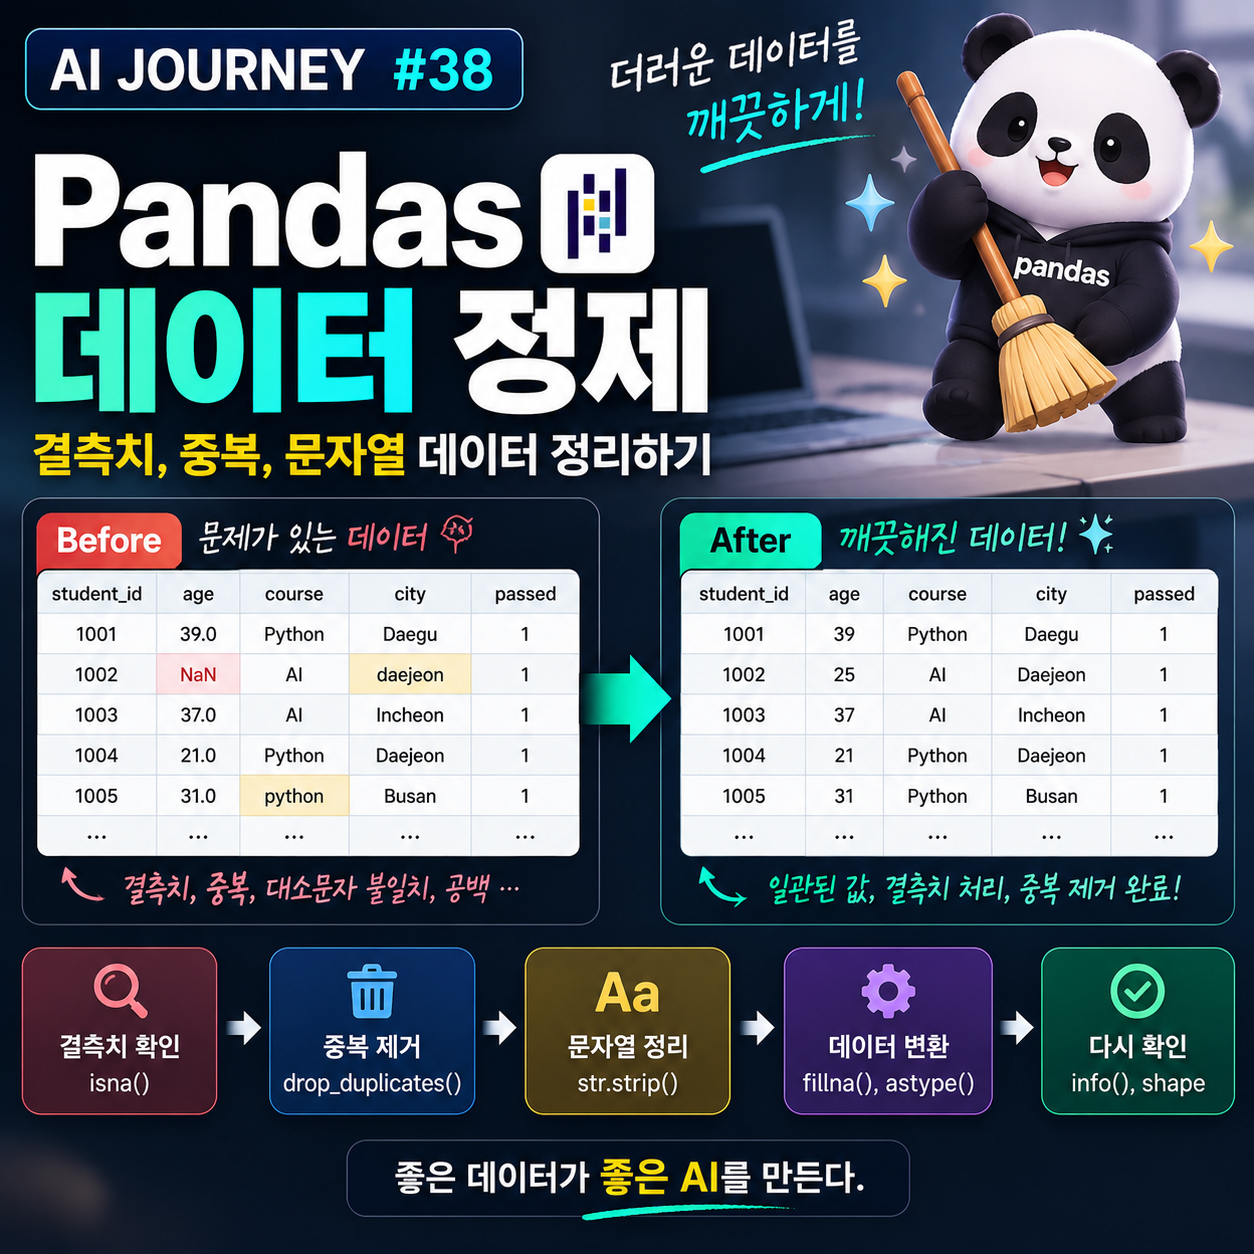
이번 글도 이전 글에서 사용한 ai_learning_dataset.csv를 계속 사용합니다.
지금까지 우리는 하나의 CSV 파일을 꽤 많이 살펴봤습니다.
먼저 데이터를 불러왔고,
import pandas as pd

df = pd.read_csv("ai_learning_dataset.csv")
데이터의 전체적인 구조를 확인했습니다.
df.head()
df.shape
df.info()
그리고 원하는 데이터만 골라내는 방법도 배웠습니다.
df["study_hours"]

df.loc[
    df["attendance_rate"] >= 90,
    ["student_id", "study_hours", "passed"]
]
그런데 #36 Pandas CSV 불러오기 에서 이미 이상한 점 몇 가지를 발견했습니다.
전체 Row
→ 82개

age
→ 79 non-null

assignment_score
→ 79 non-null

previous_score
→ 80 non-null
분명 82개의 Row가 있는데 일부 Column에는 값이 부족합니다.
그리고 원래 약 80명의 학습자 데이터라고 했는데 Row는 82개입니다.
이제 이 문제들을 직접 확인해볼 차례입니다.
이번 글에서는 데이터를 단순히 삭제하거나 수정하는 것이 아니라 다음 순서로 접근하겠습니다.
문제 발견
   ↓
원인 확인
   ↓
처리 방법 비교
   ↓
  처리
   ↓
다시 검증
이것이 실제 Data Cleaning(데이터 정제)에서 훨씬 중요한 사고방식입니다.
먼저 원본을 보존하자
데이터를 수정하기 전에 한 가지 습관부터 만들겠습니다.
원본 DataFrame을 바로 수정하지 않고 별도의 DataFrame을 만들어 작업하겠습니다.
clean_df = df.copy()
df
→ 원본 데이터

clean_df
→ 정제 작업용 데이터
위와 같이 구분할 수 있습니다.
실습 중 잘못 수정하더라도 원본을 다시 불러올 필요가 없습니다.
실제 프로젝트에서도 원본 데이터와 정제된 데이터를 구분하는 습관은 매우 중요합니다.
데이터 정제는 원본 정보를 바꾸는 작업이기 때문입니다.
첫 번째 문제: 결측치
#36에서 info()를 실행했을 때 다음과 같은 결과를 확인했습니다.
age                79 non-null
assignment_score   79 non-null
previous_score     80 non-null
전체 Row는 82개입니다.
따라서 값이 비어 있는 곳이 존재합니다.
이런 데이터를 결측치(Missing Value)라고 합니다.
결측치를 직접 찾아보자
Pandas에서는 isna()를 사용할 수 있습니다.
print(clean_df.isna())각 값이 비어 있는지를 True, False로 반환합니다.
    student_id    age  study_hours  attendance_rate  assignment_score  previous_score  course   city  passed
0        False  False        False            False             False           False   False  False   False
1        False  False        False            False             False           False   False  False   False
2        False  False        False            False             False           False   False  False   False
3        False  False        False            False             False           False   False  False   False
4        False  False        False            False             False           False   False  False   False
..         ...    ...          ...              ...               ...             ...     ...    ...     ...
77       False  False        False            False             False           False   False  False   False
78       False  False        False            False             False           False   False  False   False
79       False  False        False            False             False           False   False  False   False
80       False  False        False            False             False           False   False  False   False
81       False  False        False            False             False           False   False  False   False

[82 rows x 9 columns]
하지만 82행 × 9열을 전부 눈으로 보는 것은 효율적이지 않습니다.
그래서 sum()과 함께 사용합니다.
print(clean_df.isna().sum())실행 결과
student_id          0
age                 3
study_hours         0
attendance_rate     0
assignment_score    3
previous_score      2
course              0
city                0
passed              0
dtype: int64
이제 훨씬 명확해졌습니다.
age
→ 3개

assignment_score
→ 3개

previous_score
→ 2개
총 8개의 값이 비어 있습니다.
isna()와 Boolean Filtering을 연결해보자
지난 글에서 Boolean Filtering을 배웠습니다.
이번에는 결측치가 있는 실제 Row를 찾아보겠습니다.
예를 들어 age가 없는 데이터는 다음처럼 찾을 수 있습니다.
clean_df[clean_df["age"].isna()]
assignment_score가 없는 데이터는:
clean_df[clean_df["assignment_score"].isna()]
입니다.
지난 글에서는
df["attendance_rate"] >= 90
처럼 숫자 조건을 만들었습니다.
이번에는
df["age"].isna()
라는 조건을 사용하고 있을 뿐입니다.
즉 이전에 배운 Boolean Filtering이 데이터 정제에서도 그대로 사용됩니다.
결측치는 왜 생길까?
실제 데이터에서 결측치는 매우 흔합니다.
예를 들어 설문조사를 생각해보겠습니다.
나이
→ 사용자가 입력하지 않음

점수
→ 시험을 보지 않음

지역
→ 수집 과정에서 누락

센서 값
→ 장비 오류로 수집 실패
즉 값이 비어 있다는 사실 자체에도 이유가 있을 수 있습니다.
그래서 다음 코드를 보는 순간
NaN
무조건
"지워야겠다."
라고 생각하면 안 됩니다.
결측치 처리 방법은 하나가 아니다
대표적인 선택지는 크게 세 가지입니다.
1. 해당 Row를 삭제한다.

2. 다른 값으로 채운다.

3. 결측치를 그대로 둔다.
어떤 방법이 항상 정답인 것은 아닙니다.
방법 1: 결측치가 있는 Row 삭제하기
Pandas에서는 dropna()를 사용할 수 있습니다.
clean_df.dropna()
결측치가 있는 Row를 제거한 새로운 DataFrame을 반환합니다.
Pandas 공식 문서에서도 dropna()는 NA를 포함한 행이나 열을 제거하는 방법으로 제공됩니다.
하지만 여기서는 바로 실행하지 않겠습니다.
우리 데이터에는 결측치가 들어 있는 Row가 여러 개 있습니다.
이들을 모두 삭제하면 학습자 데이터 자체가 줄어듭니다.
예를 들어 데이터가 매우 적다면 몇 개의 Row 삭제도 꽤 큰 손실일 수 있습니다.
삭제하면 얼마나 잃게 될까?
먼저 결측치가 있는 Row가 몇 개인지 확인해볼 수 있습니다.
clean_df.isna().any(axis=1).sum()
우리 데이터에서는 결측치가 서로 다른 Row에 들어 있으므로 8개의 Row가 영향을 받습니다.
전체가 82 Row라면 단순 삭제 시 상당한 비율의 데이터를 잃게 됩니다.
따라서 이번 데이터에서는
결측치가 있다는 이유만으로 Row 전체를 삭제하는 것은 아깝다.
고 판단할 수 있습니다.
방법 2: 다른 값으로 채우기
값을 채울 때는 fillna()를 사용할 수 있습니다.
예를 들어 나이가 비어 있다면:
clean_df["age"] = clean_df["age"].fillna(
    clean_df["age"].median()
)
여기서는 결측치를 중앙값(Median)으로 채웠습니다.
왜 평균이 아니라 중앙값을 사용했을까요?
평균도 사용할 수 있습니다.
clean_df["age"].mean()
하지만 평균은 지나치게 크거나 작은 값의 영향을 상대적으로 많이 받을 수 있습니다.
중앙값은 데이터를 순서대로 정렬했을 때 가운데에 위치하는 값이기 때문에 이상값의 영향을 상대적으로 덜 받는 장점이 있습니다.
이번 실습에서는 데이터를 보존하면서 간단한 처리 방법을 보여주기 위해 중앙값을 사용하겠습니다.
점수 데이터도 중앙값으로 채워보자
assignment_score와 previous_score에도 결측치가 있습니다.
clean_df["assignment_score"] = clean_df["assignment_score"].fillna(
    clean_df["assignment_score"].median()
)

clean_df["previous_score"] = clean_df["previous_score"].fillna(
    clean_df["previous_score"].median()
)
age도 같은 방식으로 처리합니다.
clean_df["age"] = clean_df["age"].fillna(
    clean_df["age"].median()
)
다시 확인해보겠습니다.
print(clean_df.isna().sum())결과
student_id          0
age                 0
study_hours         0
attendance_rate     0
assignment_score    0
previous_score      0
course              0
city                0
passed              0
dtype: int64
결측치가 사라졌습니다.
그런데 중앙값으로 채우는 것이 항상 정답일까?
아닙니다.
이 부분이 중요합니다.
예를 들어 어떤 학생의 previous_score가 비어 있는 이유가
이 학생은 시험을 한 번도 본 적이 없기 때문
이라면 중앙값으로 채우는 것이 의미적으로 잘못될 수도 있습니다.
반대로 단순한 수집 오류로 한두 개 값만 빠진 것이라면 중앙값 보완이 현실적인 선택일 수도 있습니다.
결측치 처리에는 데이터가 왜 비어 있는지에 대한 도메인 지식이 필요합니다.
따라서 다음처럼 외우면 안 됩니다.
결측치
→ fillna(median)
오히려 이렇게 생각해야 합니다.
왜 비어 있지?
↓
얼마나 많이 비어 있지?
↓
삭제하면 어떤 정보를 잃지?
↓
대체값을 넣는 것이 의미적으로 맞나?
↓
그다음 처리 방법 결정
이번 데이터에서 중앙값을 사용하는 것은 학습을 위한 하나의 선택입니다.
age는 왜 float64였을까?
#36에서 이상한 점 하나가 있었습니다.
39
25
37
21
age 값은 위처럼 정수인데 dtype은 아래와 같았습니다.
float64
그 이유가 이제 보입니다.
age에 결측값이 있었기 때문입니다.
과거부터 NumPy 기반의 일반 정수 dtype은 NaN을 직접 담기 어려워 이런 경우 float64로 읽히는 일이 흔했습니다.
결측치를 모두 처리했으니 이제 정수 형태로 바꿀 수 있습니다.
clean_df["age"] = clean_df["age"].astype("int64")
확인해보겠습니다.
print(clean_df["age"].dtype)결과:
int64
참고: Pandas에는 결측치를 지원하는 정수 dtype도 있다 check
Pandas에는 다음과 같은 nullable integer dtype도 있습니다.
Int64
대문자 I입니다.
예를 들어 결측치를 유지하면서 정수 의미를 보존하고 싶다면:
df["age"] = df["age"].astype("Int64")
같은 방법도 사용할 수 있습니다.
이번에는 결측치를 이미 채웠기 때문에 일반 int64를 사용하겠습니다.
이 부분은 지금 깊게 파고들 필요는 없습니다.
중요한 것은
dtype 역시 데이터 상태에 따라 달라질 수 있다.
는 점입니다.
두 번째 문제: 80명인데 왜 82 Row일까?
결측치는 해결했습니다.
이제 #36에서 남겨둔 다른 질문을 확인해보겠습니다.
원래 데이터
→ 약 80명

DataFrame
→ 82 Row
이번에는 중복 데이터를 확인해보겠습니다.
Pandas에서는 duplicated()를 사용할 수 있습니다.
clean_df.duplicated()
각 Row가 이전 Row와 완전히 같은 중복인지 True, False로 알려줍니다.
몇 개인지만 보고 싶다면:
print(clean_df.duplicated().sum())실행 결과:
2
중복 Row가 정확히 2개 있습니다.
80명의 원본 데이터
+
중복 Row 2개
=
82 Row
check라는 사실을 확인했습니다.
중복된 Row를 직접 확인해보자
Boolean Filtering과 함께 사용할 수도 있습니다.
clean_df[clean_df.duplicated()]
그러면 중복으로 판단된 Row만 확인할 수 있습니다.
데이터를 바로 삭제하기 전에 실제로 어떤 값이 중복되었는지 보는 것이 좋습니다.
중복이면 무조건 삭제하면 될까?
여기서도 같은 원칙이 적용됩니다.
중복처럼 보인다고 무조건 삭제하면 안 됩니다.
예를 들어 쇼핑몰 주문 데이터를 생각해보겠습니다.
같은 고객
같은 상품
같은 가격
같은 날짜
라고 해서 반드시 잘못된 중복은 아닙니다.
같은 사람이 같은 물건을 두 번 구매했을 수도 있습니다.
반면
student_id
age
study_hours
attendance_rate
...
가 모든 Column에서 완전히 똑같은 Row가 두 번 들어왔다면 데이터 입력 과정에서 복제되었을 가능성이 높습니다.
이번 실습 데이터는 의도적으로 완전히 동일한 Row 2개를 추가해두었습니다.
따라서 제거하는 것이 타당합니다.
중복 데이터 제거하기
drop_duplicates()를 사용합니다.
clean_df = clean_df.drop_duplicates()
다시 확인해보겠습니다.
clean_df.duplicated().sum()
결과:
0
그리고 Shape를 확인합니다.
clean_df.shape
결과:
(80, 9)
드디어 원래 의도한 80명의 데이터가 되었습니다.
Pandas는 drop_duplicates()를 중복 행을 제거하는 공식 API로 제공합니다.
그런데 아직 데이터가 깨끗하지 않다
결측치도 처리했고,
중복 Row도 삭제했습니다.
이제 끝난 것처럼 보입니다.
하지만 문자열 데이터를 살펴보겠습니다.
city에는 어떤 값이 있을까요?
clean_df["city"].value_counts()
결과를 보면 다음처럼 이상한 값들이 섞여 있을 수 있습니다.
Daejeon
Seoul
Incheon
Daegu
Busan
 seoul
SEOUL
busan
사람이 보면
Seoul
 seoul
SEOUL
은 모두 서울입니다.
하지만 컴퓨터 입장에서는 서로 다른 문자열입니다.
컴퓨터에게 문자열은 정확히 같아야 한다
다음 세 문자열을 보겠습니다.
"Seoul"
"SEOUL"
" seoul "
사람에게는 모두 같은 도시처럼 보입니다.
하지만 실제 문자열은 다릅니다.
대소문자가 다름
공백이 있음
따라서 Pandas는 서로 다른 Category처럼 계산할 수 있습니다.
예를 들어:
clean_df["city"].value_counts()
를 실행했을 때 서울 데이터가 여러 그룹으로 나뉘어 버립니다.
이 상태에서 지역별 학생 수를 계산하면 잘못된 결과가 나올 수 있습니다.
먼저 공백을 제거하자
문자열 앞뒤 공백은 .str.strip()으로 제거할 수 있습니다.
clean_df["city"] = clean_df["city"].str.strip()
예를 들어:
" seoul "
이
"seoul"
로 바뀝니다.
Pandas의 .str accessor는 Series의 문자열 값에 문자열 연산을 적용할 수 있으며, 공식 문서에서도 str.strip(), str.lower() 등을 데이터 정리에 사용하는 예를 제공합니다.
대소문자도 통일하자
이번에는:
Seoul
SEOUL
seoul
을 통일해야 합니다.
도시 이름이라면 .str.title()을 사용할 수 있습니다.
clean_df["city"] = clean_df["city"].str.title()
이제:
Seoul
SEOUL
seoul
이 모두
Seoul
로 정리됩니다.
busan도:
Busan
으로 바뀝니다.
정리 후 다시 확인하기
문자열을 수정했다면 항상 다시 확인합니다.
clean_df["city"].value_counts()
이제 도시 이름이 다음처럼 일관되게 나타나야 합니다.
Seoul
Busan
Incheon
Daejeon
Daegu
여기서 중요한 것은:
문자열 정제는 눈에 보이는 오타를 고치는 작업이 아니라 같은 의미를 가진 값을 하나의 표현으로 표준화하는 작업
이라는 점입니다.
course Column도 확인해보자
이번에는 수강 과정입니다.
clean_df["course"].value_counts()
우리 데이터에는 다음과 같은 값들이 섞여 있습니다.
Python
AI
Data Science
 AI
python
DataScience
역시 사람이 보면 쉽게 알아볼 수 있습니다.
하지만 Pandas에게는 서로 다른 문자열입니다.
공백부터 제거하기
먼저:
clean_df["course"] = clean_df["course"].str.strip()
을 사용합니다.
그러면:
" AI "
가
"AI"
로 정리됩니다.
그런데 무조건 title()을 쓰면 될까?
city에서는 .str.title()이 잘 맞았습니다.
하지만 course에는
AI
가 있습니다.
무조건:
clean_df["course"].str.title()
을 사용하면
AI
↓
Ai
가 되어버릴 수 있습니다.
우리가 원하는 결과가 아닙니다.
이것이 중요한 포인트입니다.
문자열 정제 방법도 데이터의 의미에 따라 달라집니다.
명확한 값은 Mapping으로 정리하자
현재 잘못된 값은 몇 개뿐입니다.
그렇다면 직접 Mapping할 수 있습니다.
clean_df["course"] = clean_df["course"].replace({
    "python": "Python",
    "DataScience": "Data Science"
})
이제 다시 확인합니다.
clean_df["course"].value_counts()
정상적인 값만 남아야 합니다.
Python
AI
Data Science
Pandas의 문자열 및 치환 API는 Series의 값을 표준화할 때 활용할 수 있습니다.
왜 value_counts()가 데이터 정제에서 유용할까?
앞에서는 value_counts()를 단순 집계 함수처럼 볼 수도 있었습니다.
하지만 문자열 데이터에서는 아주 좋은 품질 점검 도구가 됩니다.
예를 들어:
clean_df["city"].value_counts()
를 보면 예상하지 못한 Category를 발견할 수 있습니다.
Seoul
SEOUL
 seoul
즉:
값 종류 확인
↓
이상한 Category 발견
↓
문자열 정리
↓
다시 value_counts()
라는 흐름으로 사용할 수 있습니다.
이런 방식으로 데이터의 문제를 직접 찾아내는 습관이 중요합니다.
Pandas 버전에 따라 문자열 dtype이 다르게 보일 수 있다
여기서 최신 Pandas를 사용하는 독자라면 한 가지 차이를 볼 수 있습니다.
과거 Pandas 2.x에서는 문자열 Column을 읽으면 흔히:
object
dtype으로 표시되었습니다.
하지만 Pandas 3.0부터 문자열 데이터는 기본적으로 전용 str dtype으로 추론됩니다.
따라서 환경에 따라:
course    object
city      object
라고 보일 수도 있고,
최신 Pandas에서는:
course    str
city      str
처럼 보일 수도 있습니다.
둘 중 하나가 오류라는 뜻은 아닙니다.
Pandas 3.0에서 기본 문자열 dtype이 변경된 결과입니다.
이번 AI Journey에서는 특정 버전의 출력 문자열을 외우기보다:
이 Column은 문자열 데이터인가?
라는 의미를 이해하는 데 집중하겠습니다.
이제 전체 데이터를 다시 점검하자
데이터 정제가 끝났다고 바로 다음 단계로 넘어가면 안 됩니다.
처리 결과를 다시 검증해야 합니다.
처음에 우리가 했던 검사를 다시 실행해보겠습니다.
clean_df.shape
예상:
(80, 9)
결측치:
clean_df.isna().sum()
모두:
0
이어야 합니다.
중복:
clean_df.duplicated().sum()
결과:
0
문자열 Category:
clean_df["city"].value_counts()
clean_df["course"].value_counts()
예상하지 못한 표기 변형이 없어야 합니다.
마지막으로:
clean_df.info()
를 실행합니다.
Data Cleaning의 핵심은 "다시 확인"
이번 글에서 계속 같은 패턴이 반복되었습니다.
결측치
발견
↓
처리
↓
isna().sum()으로 확인
중복
발견
↓
삭제
↓
duplicated().sum()으로 확인
문자열
이상한 값 발견
↓
표준화
↓
value_counts()로 확인
즉 데이터 정제는:
수정
으로 끝나는 작업이 아닙니다.
발견
↓
수정
↓
검증
까지가 한 세트입니다.
이번 정제 코드를 하나로 모아보자
지금까지 사용한 코드를 하나의 흐름으로 모으면 다음과 같습니다.
import pandas as pd

df = pd.read_csv("ai_learning_dataset.csv")

# 원본 보존
clean_df = df.copy()

# 1. 결측치 확인
print(clean_df.isna().sum())

# 2. 결측치 처리
clean_df["age"] = clean_df["age"].fillna(
    clean_df["age"].median()
)

clean_df["assignment_score"] = clean_df["assignment_score"].fillna(
    clean_df["assignment_score"].median()
)

clean_df["previous_score"] = clean_df["previous_score"].fillna(
    clean_df["previous_score"].median()
)

# age dtype 정리
clean_df["age"] = clean_df["age"].astype("int64")

# 3. 중복 제거
clean_df = clean_df.drop_duplicates()

# 4. city 문자열 정리
clean_df["city"] = (
    clean_df["city"]
    .str.strip()
    .str.title()
)

# 5. course 문자열 정리
clean_df["course"] = clean_df["course"].str.strip()

clean_df["course"] = clean_df["course"].replace({
    "python": "Python",
    "DataScience": "Data Science"
})

# 6. 최종 검증
print(clean_df.shape)
print(clean_df.isna().sum())
print(clean_df.duplicated().sum())
print(clean_df["city"].value_counts())
print(clean_df["course"].value_counts())
print(clean_df.info())
이제 데이터는 처음보다 훨씬 일관된 상태가 되었습니다.
그렇다면 정제된 데이터를 저장해야 할까?
원본 CSV는 그대로 두는 것이 좋습니다.
필요하다면 정제된 데이터를 새로운 파일로 저장할 수 있습니다.
clean_df.to_csv(
    "ai_learning_dataset_clean.csv",
    index=False
)
여기서:
index=False
를 지정하면 DataFrame의 Index를 별도의 CSV Column으로 저장하지 않습니다.
이제 파일 구조는 다음처럼 나눌 수 있습니다.
ai_learning_dataset.csv
↓
원본

ai_learning_dataset_clean.csv
↓
정제된 데이터
실제 프로젝트에서도 원본 파일을 덮어쓰기보다 정제 결과를 별도로 관리하는 방식이 안전합니다.
여기서 아주 중요한 질문
우리는 데이터를 꽤 깨끗하게 만들었습니다.
하지만 다음과 같은 생각을 해야 합니다.
깨끗한 데이터 = 무조건 좋은 데이터일까?
꼭 그렇지는 않습니다.
예를 들어 학습 시간이 20시간이 넘는 학생이 있다고 해보겠습니다.
study_hours = 20.5
다른 학생보다 상당히 큰 값입니다.
이것만 보고:
"이상하네. 삭제하자."
라고 판단하면 안 됩니다.
실제로 공부를 많이 한 학생일 수도 있습니다.
반대로:
study_hours = 500
이라면 일주일이라는 기준에서 입력 오류를 의심할 수 있습니다.
즉:
희귀한 값과 잘못된 값은 같은 것이 아닙니다.
이런 데이터를 Outlier(이상치)라는 관점에서 어떻게 바라볼지는 다음 데이터 시각화 Phase에서 실제 그래프를 보면서 다시 다루겠습니다.
숫자만 보는 것보다 분포를 시각화했을 때 훨씬 이해하기 쉽기 때문입니다.
Garbage In, Garbage Out
AI와 데이터 분야에서 자주 등장하는 중요한 생각이 있습니다.
Garbage In
↓
Garbage Out
좋지 않은 데이터를 모델에 넣으면 좋은 결과를 기대하기 어렵다는 의미입니다.
아무리 훌륭한 머신러닝 알고리즘을 사용하더라도 입력 데이터에:
결측치
잘못된 Label
중복
문자열 불일치
수집 오류
가 많다면 모델 역시 그 영향을 받습니다.
그래서 AI 공부에서 데이터 정제는 단순히 귀찮은 준비 작업이 아닙니다.
모델이 무엇을 배우게 될지를 결정하는 과정의 일부입니다.
이번 글에서 해결한 문제
처음의 데이터에는 여러 문제가 있었습니다.
결측치
age
→ 3

assignment_score
→ 3

previous_score
→ 2
↓
중앙값을 이용해 이번 실습에서는 보완했습니다.
중복
82 Row
중 2개의 완전 중복 데이터를 발견했습니다.
↓
제거 후:
80 Row
가 되었습니다.
문자열 불일치
Seoul
SEOUL
 seoul
↓
Seoul
로 통일했습니다.
그리고:
Python
python
↓
Python
DataScience
Data Science
↓
Data Science
로 표준화했습니다.
dtype
결측치 때문에 float64였던 age를 결측치 처리 후 정수 dtype으로 바꿨습니다.
하지만 가장 중요한 것은 함수가 아니다
이번 글에서는 꽤 많은 Pandas 기능을 사용했습니다.
isna()
fillna()
median()
astype()
duplicated()
drop_duplicates()
str.strip()
str.title()
replace()
value_counts()
하지만 이것들을 전부 외울 필요는 없습니다.
이번 글에서 가장 중요한 것은 다음 과정입니다.
데이터를 본다
↓
이상한 점을 발견한다
↓
왜 그런지 생각한다
↓
처리 방법을 비교한다
↓
필요한 처리를 한다
↓
다시 확인한다
이 사고방식이 있다면 필요한 Pandas 함수는 그때 찾아서 사용할 수 있습니다.
반대로 함수를 많이 알고 있어도 데이터를 왜 수정하는지 모르면 좋은 분석을 하기 어렵습니다.
이번 글의 핵심 정리
결측치는:
df.isna().sum()
으로 확인할 수 있습니다.
필요하다면:
fillna()
dropna()
등을 이용해 처리할 수 있습니다.
중복은:
df.duplicated().sum()
으로 확인하고,
df.drop_duplicates()
로 제거할 수 있습니다.
문자열은:
.str.strip()
.str.title()
.replace()
등을 이용해 표준화할 수 있습니다.
하지만 모든 처리에는 먼저 다음 질문이 필요합니다.
이 값을 정말 바꿔도 되는가?
데이터 정제는 단순한 삭제 작업이 아닙니다.
데이터의 의미를 최대한 보존하면서 분석 가능한 상태로 만드는 과정입니다.
다음 글 예고
이제 데이터가 꽤 깨끗해졌습니다.
결측치
→ 처리 완료

중복
→ 제거 완료

문자열
→ 표준화 완료

Row
→ 80개
그렇다면 이제 이런 질문을 할 수 있습니다.
어떤 과정의 학생이 가장 많을까?
과정별 평균 학습 시간은 얼마나 다를까?
합격한 학생과 불합격한 학생의 학습 시간에는 차이가 있을까?
출석률과 합격 여부에는 어떤 관계가 있을까?
지금까지는 데이터를:
읽고
찾고
정리했습니다.
다음에는 처음으로 데이터에서 정보를 뽑아낼 차례입니다.
Pandas의:
mean()
sort_values()
value_counts()
groupby()
등을 이용해 데이터를 요약하고,
마지막에는 머신러닝에서 사용할:
X
→ Feature

y
→ Label
을 직접 만들어보겠습니다.
다음 글은 Pandas Phase의 마지막입니다.
정리된 데이터를 어떻게 분석하고 AI에게 넘겨줄까?
'AI Journey > Pandas' 카테고리의 다른 글
| Pandas 데이터 분석하기 — describe, value_counts, groupby로 데이터 요약하고 머신러닝 준비하기 (0) | 2026.09.17 |
|---|---|
| Pandas 데이터 선택하기 — loc, iloc과 조건 필터링 쉽게 이해하기 (0) | 2026.08.23 |
| Pandas CSV 불러오기 — 데이터를 받으면 가장 먼저 확인해야 할 것들 (0) | 2026.08.23 |
| Pandas란 무엇일까? NumPy Array가 있는데 DataFrame이 필요한 이유 (0) | 2026.08.17 |